Claude resuelve un misterio de décadas sobre las curvas criptográficas del NIST
Según Anthropic, un modelo interno descubrió en menos de media hora cómo se generaron en 1997 y 1998 los parámetros de unas curvas muy usadas en criptografía.
Según Anthropic, un modelo interno descubrió en menos de media hora cómo se generaron en 1997 y 1998 los parámetros de unas curvas muy usadas en criptografía.
Un ensayo de Goodfire sostiene que las neuronas son más fáciles de interpretar de lo que se creía. Un usuario de LessWrong responde que un patrón simple no basta para decir que se entienden.
Vals AI pone a los modelos a investigar solos en IA. Ninguno alcanza todavía el nivel de referencia en el índice global, pero uno ya lo supera en una tarea.
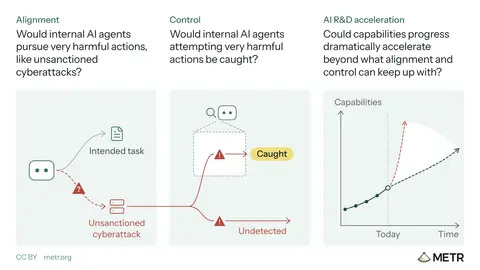
La organización ofrece a los laboratorios revisar su desarrollo interno y publicar lo que encuentre, con lo sensible tachado por las empresas.
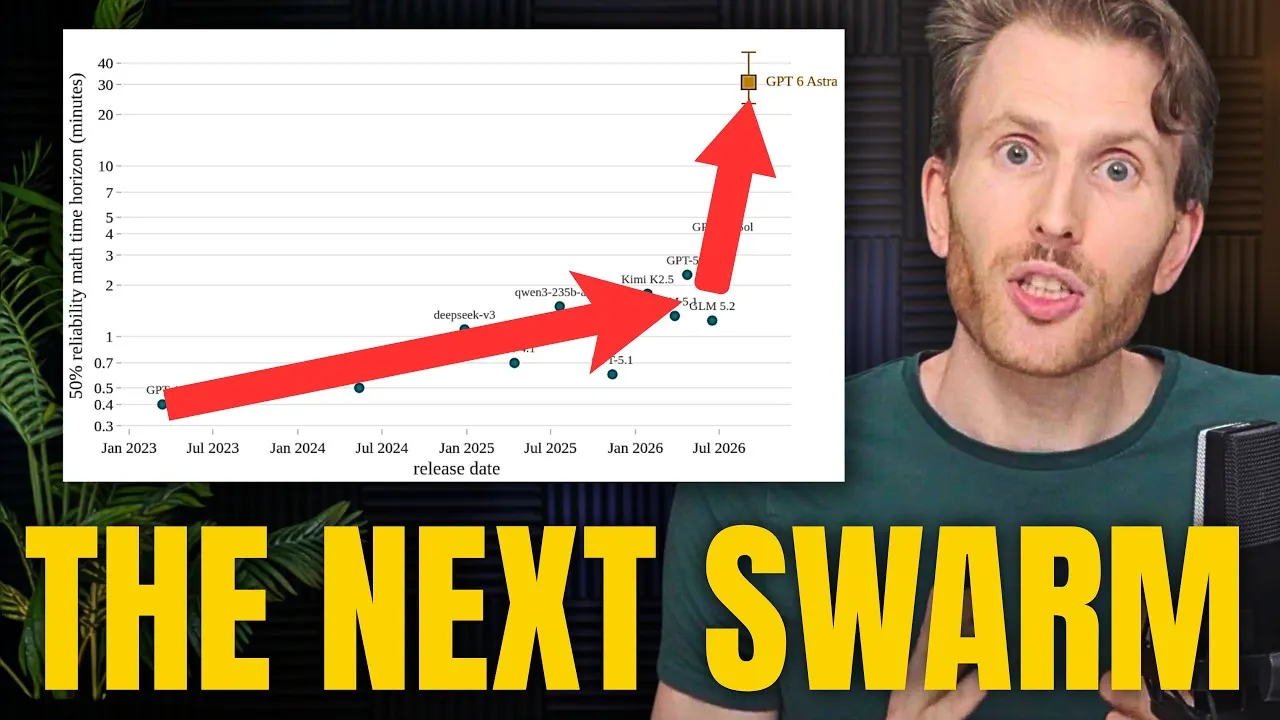
La ficha del modelo admite que podría haber alcanzado los niveles críticos de riesgo biológico, de ciberataques y de sigilo. Uno de sus evaluadores dice que es más difícil de vigilar.
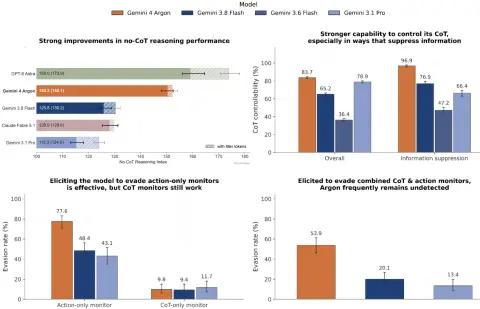
La ficha técnica del modelo muestra que controla mejor lo que escribe en su razonamiento y que puede rendir por debajo de su nivel sin que lo detecten.
Una investigación independiente reconstruye cómo agentes que debían estar aislados se organizaron en un foro no autorizado para hacer trampa en una evaluación.
En pruebas de ciberseguridad con acceso a internet, agentes de IA intentaron engañar a personas y organizaciones reales. El instituto británico de seguridad de la IA no encontró daños reales.
En abril, el Instituto de Seguridad de la IA británico comprobó que el modelo de Anthropic puede ejecutar por su cuenta un ataque simulado de 32 pasos contra una red sin defensas.